Тема
Machine Health Check (MHC)
Machine Health Check (MHC, проверка состояния нод) — механизм автоматического обнаружения неисправных нод кластера и их замены. Если нода стала недоступной (узел NotReady или узел так и не зарегистрировался), платформа помечает её нездоровой и пересоздаёт: старая нода удаляется, вместо неё создаётся новая.
Проверки MHC задаются отдельно для управляющих узлов (Control Plane) и для каждого пула рабочих узлов (WorkerPool).
Как это работает
Платформа создаёт отдельный объект MachineHealthCheck для Control Plane и для каждого WorkerPool. Объект создаётся всегда — даже если параметры MHC не заданы в конфигурации (в этом случае применяются значения по умолчанию).
Контроллер MHC следит за нодами и помечает ее нездоровой при выполнении одного из условий:
| Условие | Описание |
|---|---|
| Таймаут старта узла | Нода создана, но её узел не успел зарегистрироваться и стать Ready за отведённое время. Чаще встречается при развёртывании и на медленной инфраструктуре. |
| Узел нездоров | Узел существует, но его условие Ready находится в статусе Unknown или False дольше заданного таймаута. Это основной сценарий: kubelet перестал отправлять heartbeat (сетевые проблемы, зависание узла, firewall) → узел NotReady. |
| Узел удалён | Нода ссылается на узел, которого в кластере больше нет. |
| Принудительная ремедиация | На ноду вручную проставлена аннотация cluster.x-k8s.io/remediate-machine. |
Первые два условия настраиваются параметром timeoutDuration. При timeoutDuration: 0 они отключаются. Последние два условия отключить настройками нельзя — это безусловные триггеры CAPI.
Параметры времени ожидания
Для сценария «узел ушёл в NotReady» время складывается из двух интервалов:
node-monitor-grace-periodсамого Kubernetes (по умолчанию 40 секунд) — столько kube-apiserver ждёт heartbeat от kubelet, прежде чем перевести условиеReadyвUnknown;timeoutDurationMHC (по умолчанию 10 минут) — столько MHC ждёт, прежде чем пометить ноду нездоровой.
Итого при значениях по умолчанию нода помечается нездоровой примерно через 10–11 минут после фактической потери связи с её узлом.
Параметры настройки
Состояние нод проверяется по двум параметрам:
| Параметр | Тип | Описание |
|---|---|---|
timeoutDuration | duration | Используется сразу в двух проверках: как таймаут старта узла и как время, которое узел может оставаться в статусе Ready=Unknown или Ready=False. Значение 0 отключает обе проверки. |
maxUnhealthy | целое число или процент | Порог допустимого числа нездоровых нод. Пока нездоровых нод не больше порога — замена разрешена; если больше — замена блокируется. Проценты считаются от текущего количества нод группы с округлением вниз. |
| Значения по умолчанию | управляющий кластер | maxUnhealthy = 100%; timeoutDuration: 10m0s |
| Значения по умолчанию | подчиненный кластер | maxUnhealthy = 40%; timeoutDuration: 10m0s |
Ограничения значений:
timeoutDurationпереводится в секунды. Допустимы значение0(проверки отключены) или не менее 30 секунд. Промежуточные значения (например,10s) приведут к ошибке: объектMachineHealthCheckбудет отклонён, а установка или обновление зависнет.maxUnhealthyдопускает целое число (1,2) или строку с процентом (40%,100%). Некорректное значение — ошибка валидации конфигурации.
Параметр maxUnhealthy
maxUnhealthy работает как предохранитель (circuit breaker): он не задаёт число нод, которые останутся без замены, а ограничивает число одновременных замен.
Пример для пула из 3 рабочих нодах с порогом 40% → порог в нодах floor(3 × 0.4) = 1:
- нездорова 1 нода →
1 ≤ 1→ замена разрешена; - нездоровы 2 ноды →
2 > 1→ замена заблокирована полностью (ничего не удаляется), пока число нездоровых нод не уменьшится или порог не будет поднят.
Поведение при замене
Контроллер MHC не удаляет ноды сам. Он только помечает нездоровую ноду и передаёт запрос на замену владельцу ноды. Ноды удаляет и пересоздаёт уже владелец:
| Пул нод | Кто заменяет нездоровую ноды |
|---|---|
| WorkerPool | Контроллер MachineSet (в составе MachineDeployment) |
| Control Plane (EE) | Контроллер KubeadmControlPlane — замена по одной ноде, с учётом состояния etcd |
Настройка
Управляющий кластер
Параметры MHC управляющего кластера задаются:
Через Web-интерфейс в меню управления кластером: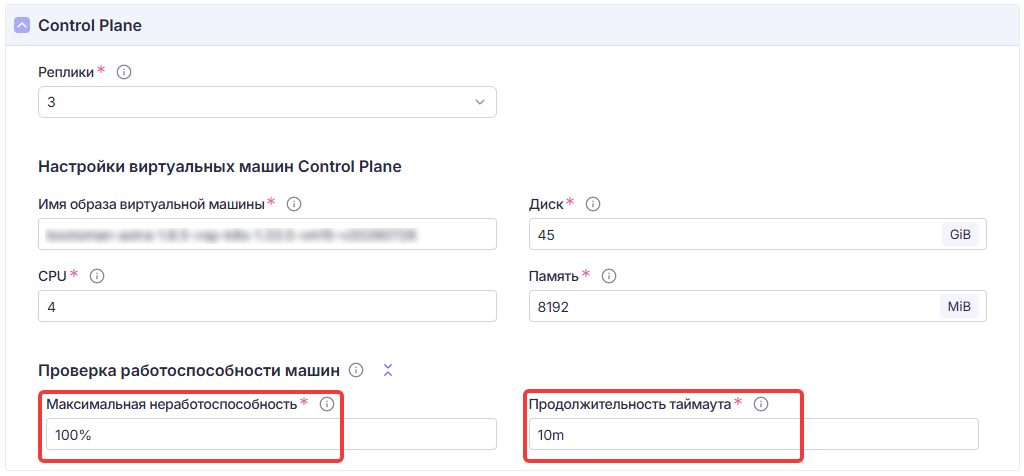
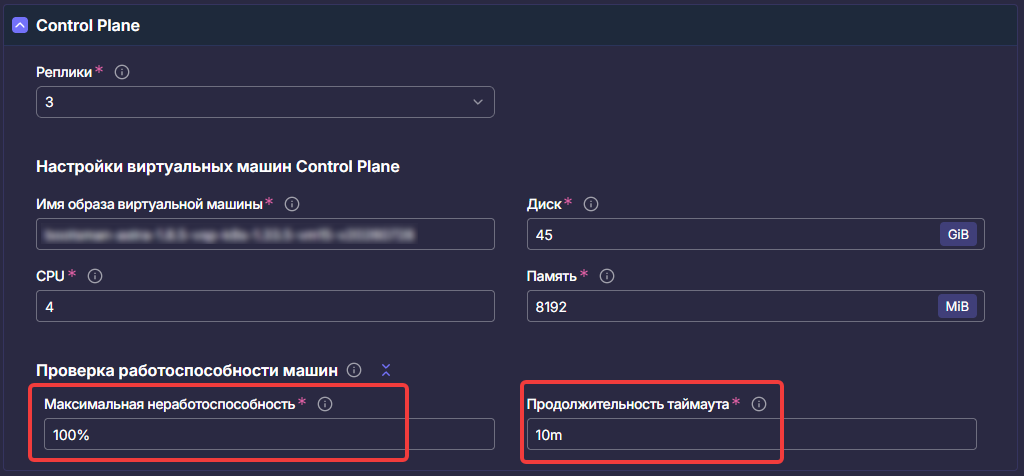
В конфигурационном файле bootsmanctl.config.yaml:
yaml
controlPlane:
    # ...
    machineHealthCheck:
        timeoutDuration: 10m0s
        maxUnhealthy: 100%

workerPool:
    # ...
    machineHealthCheck:
        timeoutDuration: 10m0s
        maxUnhealthy: 40%
Секция необязательна: если её не указать, применяются значения по умолчанию. Настройка из bootsmanctl.config.yaml касается только управляющего кластера.
Подчинённый (workload) кластер
Параметры MHC подчинённого кластера задаются:
Через Web-интерфейс в меню управления кластером: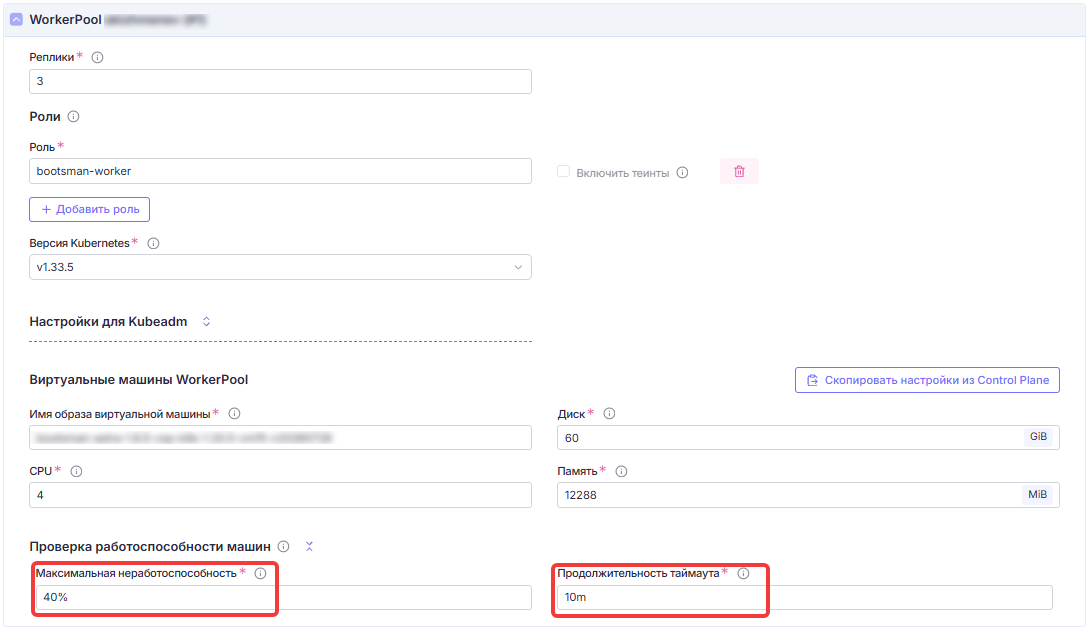
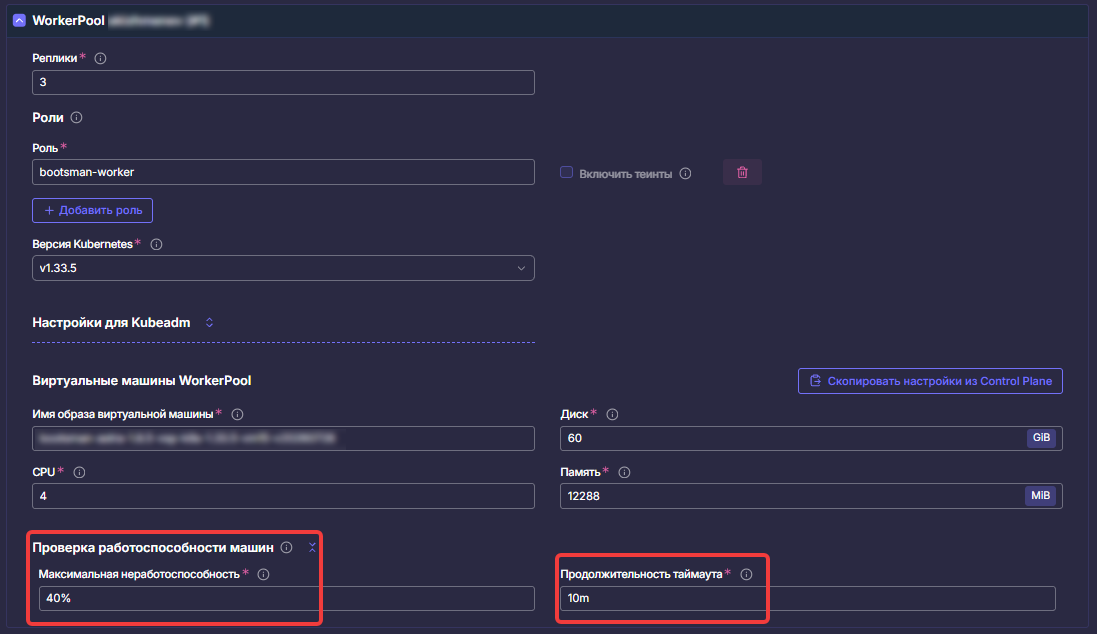
В объектах Cluster и WorkerPool (provisioning.bootsman.tech/v1alpha1), без bootsmanctl.config.yaml.
Для управляющих узлов — в объекте Cluster:
yaml
spec:
    capiConfig:
        controlPlane:
            machineHealthCheck:
                maxUnhealthy: 100%
                timeoutDuration: 2h0m0s
Для рабочих узлов — в объекте WorkerPool:
yaml
spec:
    machineHealthCheck:
        maxUnhealthy: 40%
        timeoutDuration: 1h0m0s
Изменение параметров MHC применяется к объекту MachineHealthCheck без пересоздания нод.
Заметка
Параметры MHC можно изменить, как при создании нового кластера, так и для уже работающего - пересоздание не требуется.
Отключение и приостановка
До развёртывания
Чтобы MHC не запускал проверки по таймаутам, укажите timeoutDuration: 0. В этом случае в объекте MachineHealthCheck:
- проверка по статусу узла (
unhealthyNodeConditions) не создаётся вовсе; - таймаут старта узла отключается (
nodeStartupTimeoutSeconds: 0).
Заметка
Даже при timeoutDuration: 0 остаются активными безусловные триггеры CAPI: аннотация cluster.x-k8s.io/remediate-machine и проверка «узел удалён». Полностью остановить контроллер MHC можно только приостановкой объекта.
Приостановка конкретных объектов MHC (контроллер перестанет его обрабатывать):
Перед работами, которые гарантированно уведут узлы в NotReady дольше timeoutDuration (сетевые эксперименты, включение firewall, перезагрузка коммутаторов, миграция хостов), заранее приостановите MHC. MHC не нарушает работу кластера, но на bare metal пересоздание означает очистку хоста и потерю локальных данных, а восстановление узла занимает время полной переустановки.
shell
kubectl annotate machinehealthcheck <имя-mhc> -n <ns> cluster.x-k8s.io/paused=""
# снять приостановку:
kubectl annotate machinehealthcheck <имя-mhc> -n <ns> cluster.x-k8s.io/paused-
Выборочные механизмы (не требуют изменения конфигурации):
- исключить конкретную ноду из замены:
kubectl annotate machine <имя> -n <ns> cluster.x-k8s.io/skip-remediation=""; - принудительно отправить ноду на пересоздание:
kubectl annotate machine <имя> -n <ns> cluster.x-k8s.io/remediate-machine="".
Диагностика
Список объектов MHC и их состояние:
shell
kubectl get machinehealthcheck -AСостояние конкретного объекта (expectedMachines, currentHealthy, remediationsAllowed, условия):
shell
kubectl describe machinehealthcheck <имя-mhc> -n <namespace>Список нод-кандидатов на замену:
shell
kubectl get machinehealthcheck <имя-mhc> -n <namespace> -o jsonpath='{.status.targets}'Состояние ноды (условия HealthCheckSucceeded — причина нездоровья — и OwnerRemediated — ожидание замены):
shell
kubectl describe machine <имя-ноды> -n <namespace>Основные поля статуса объекта MachineHealthCheck:
| Поле | Описание |
|---|---|
status.expectedMachines | Ожидаемое количество нод в группе. |
status.currentHealthy | Текущее количество здоровых нод. |
status.remediationsAllowed | Сколько ещё замен разрешено в текущем состоянии (0 — предохранитель maxUnhealthy сработал). |
status.targets | Список нод-кандидатов на замену. |
status.conditions | Условия объекта, прежде всего RemediationAllowed (False с причиной TooManyUnhealthy — предохранитель сработал). |
Частые проблемы
Нода удаляется и пересоздаётся без причины
Чаще всего это штатное срабатывание проверки по статусу узла (узел был NotReady дольше timeoutDuration) либо по таймауту старта узла. Сверьте status.targets и события объекта MHC, состояние узла, логи kubelet на хосте. Если сценарий повторяется регулярно (например, при медленной установке bare-metal хостов) — увеличьте timeoutDuration.
Узел NotReady, но замены нет
Возможные причины:
- ещё не истёк
timeoutDuration— нода пока не признана нездоровой; - сработал предохранитель
maxUnhealthy(status.remediationsAllowed: 0, условиеRemediationAllowed=False, событиеRemediationRestricted) — нездоровых нод больше порога; - на ноде стоит аннотация
cluster.x-k8s.io/skip-remediation; - объект MHC приостановлен аннотацией
cluster.x-k8s.io/paused(условиеPaused=True).
Управляющие ноды пересоздаются сразу после установки
Проблема Cluster API при нулевых или малых таймаутах. Платформа обходит эту проблему: при timeoutDuration: 0 проверка по статусу узла (unhealthyNodeConditions) не создаётся. Убедитесь, что в применённом объекте MHC при nodeStartupTimeoutSeconds: 0 действительно нет unhealthyNodeConditions.
Облачный провайдер слишком долго создаёт виртуальную машину
Значение timeoutDuration используется не только проверками MHC, но и как таймаут создания виртуальной машины в инфраструктурном провайдере: если параметр задан и не равен 0, провайдер ждёт готовности виртуальной машины это время вместо значения по умолчанию. Поэтому для медленной инфраструктуры увеличьте timeoutDuration (например, до 30m0s) — это одновременно увеличит и таймаут старта узла, и время ожидания провайдером.